【備忘録】pandas.Series の mask は True の要素に where は False の要素にアクセスする
はじめに
表形式のデータを pandas で処理しているとよく(毎回?)mask と where の使い分け方を迷うので、未来の自分のために備忘録を書いておきます1。
pandas.Series の mask と where
pandas.Series.mask と pandas.Series.where はどちらも pandas.Series のメソッドで、同じ引数を受け取ります。
mask は cond が True の行のみ s の要素を others の対応する要素で置換します。where はその逆で cond が False の行のみ s の要素を others の対応する要素で置換します
import pandas as pd

s = pd.Series([1, 2, 3, 4, 5])  # length = 5
othres = pd.Series([-1, -2, -3, -4, -5])  # length = 5
cond = pd.Series([False, True, True, False, True])  # bool array, length = 5

s.mask(cond, others)  # `cond` が True だと置換
s.where(cond, others)  # `cond` が Falase だと置換
上のコードだと mask, where の返す Series は次の表の通りになります。
| s | others | cond | mask | where |
|---|---|---|---|---|
| 1 | -1 | False | 1 | -1 |
| 2 | -2 | True | -2 | 2 |
| 3 | -3 | True | -3 | 3 |
| 4 | -4 | False | 4 | -4 |
| 5 | -5 | True | -5 | 5 |
その他
mask も where も引数 inplace を True にしない限り元の Series を上書きしません。inplace はデフォルトでは False です。
others はスカラーを指定すると勝手にブロードキャストしてくれます。others はデフォルトでは numpy.nan, pd.NA 等の元のデータ型に対応した欠損値になります。
- 未来の自分がこの備忘録の存在を忘れている可能性は考えないことにした↩
scikit-learn で数値・カテゴリ・テキストのカラムが混在する表データに fit, transform できる前処理パイプラインを作成する
はじめに
scikit-learn で数値・カテゴリ・テキストのカラムが混在する表データをうまいこと扱える前処理パイプラインの作り方を紹介します。
scikit-learn にはデータの前処理パイプラインを組むのに有用なクラスが色々備わっているにも関わらず、知名度が微妙だなと感じたことが紹介のモチベーションです。
本記事に登場するコードは Google colab のこちらの Notebook で動作確認しました。
前処理対象のデータ
飲食店のレビューデータをイメージした表形式のデータです。
| 味 | 接客 | 価格 | 性別 | コメント |
|---|---|---|---|---|
| 普通 | 悪い | 4381 | 女 | nan |
| 美味 | 最高 | nan | 女 | nan |
| 美味 | 悪い | 4152 | 女 | パスタが美味しい |
| 美味 | 最高 | 4363 | nan | 清潔で雰囲気が良いお店です |
| 美味 | 最悪 | 3416 | 男 | nan |
| 美味 | 最高 | 3296 | 女 | nan |
| 美味 | 最悪 | 3523 | 男 | nan |
| 不味い | 最高 | 1929 | 男 | nan |
| 普通 | 最高 | 1780 | 男 | nan |
| 不味い | 良い | 3288 | nan | nan |
| 美味 | 良い | 2874 | nan | nan |
| 不味い | 悪い | 3319 | 男 | nan |
| 美味 | 良い | 4974 | 女 | nan |
| 普通 | 悪い | 4540 | 男 | nan |
| 普通 | 悪い | 1858 | 男 | 厨房があまり清潔でないと感じました |
| 普通 | 悪い | 2052 | 男 | 量が少ないので食が太い人には物足りないかも? |
| 普通 | 最高 | 4209 | 男 | nan |
| 不味い | 最高 | 1464 | 男 | nan |
| 不味い | 悪い | nan | 男 | いつも混んでいるので要予約です |
| 美味 | 最高 | 3432 | 女 | nan |
カテゴリ(味, 接客, 性別)・数値(価格)・文章(コメント)のカラムが混在しています。
前処理の仕様は以下の通りとします。
味は値に対応する整数値を割り当てる: "不味い": 0, "普通": 1, "美味": 2.接客も値に対応する整数値を割り当てる: "最悪": 0, "悪い": 1, "良い": 2, "最高": 3.価格は欠損値を中央値で補完した上で標準化する。性別は欠損値を"無回答"で補完した上で整数値を割り当てる: "無回答": 0, "男": 1, "女": 2.コメントの欠損値を"未記入"で補完し、分かち書きをTF-IDFベクトルに変換し、SVDで2次元に次元削減する。コメントの欠損値を"未記入"で補完し、分かち書きをTF-IDFベクトルに変換し、LDAで2次元に次元削減する。
モジュールをインポートする
from typing import List, Tuple

try:
    from janome.tokenizer import Tokenizer
except ImportError:
    !pip install janome --quiet
    from janome.tokenizer import Tokenizer
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.decomposition import LatentDirichletAllocation as LDA, TruncatedSVD
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import FeatureUnion, Pipeline
from sklearn.preprocessing import OrdinalEncoder, StandardScaler
前処理のコード例
前処理用の関数 preprocess1 を用意しました。
def tokenize(text: str) -> List[str]:
    """文章の分かち書きを得る"""
    tokenizer = Tokenizer()
    bow = [t.surface for t in tokenizer.tokenize(text) if t.surface.strip()]
    return bow


def preprocess1(data: pd.DataFrame) -> pd.DataFrame:
    """データに前処理を適用する"""
    # カテゴリ項目に対する前処理
    data_preprocessed = pd.DataFrame(index=data.index)
    data_preprocessed[["味", "接客", "性別"]] = data[["味", "接客", "性別"]].copy()
    data_preprocessed["性別"] = SimpleImputer(strategy="constant", fill_value="無回答").fit_transform(data_preprocessed[["性別"]])
    encoder = OrdinalEncoder(categories=[["不味い", "普通", "美味"], ["最悪", "悪い", "良い", "最高"], ["無回答", "男", "女"]])
    data_preprocessed[["味", "接客", "性別"]] = encoder.fit_transform(data_preprocessed[["味", "接客", "性別"]])
    # 数値項目に対する前処理
    data_preprocessed["価格"] = data["価格"].copy()
    data_preprocessed["価格"] = SimpleImputer(strategy="median").fit_transform(data_preprocessed[["価格"]])
    data_preprocessed["価格"] = StandardScaler().fit_transform(data_preprocessed[["価格"]])
    # テキスト項目に対する前処理
    vectorizer = TfidfVectorizer(token_pattern=r"(?u)\b\w+\b", tokenizer=tokenize, preprocessor=lambda x: x if isinstance(x, str) else "未記入")
    tfidf_vector = vectorizer.fit_transform(data["コメント"])
    svd_components = TruncatedSVD(n_components=2).fit_transform(tfidf_vector)
    data_preprocessed[["svd0", "svd1"]] = svd_components
    lda_components = LDA(n_components=2, n_jobs=-1, random_state=1).fit_transform(tfidf_vector)
    data_preprocessed[["lda0", "lda1"]] = lda_components
    # 前処理済データを返す
    return data_preprocessed
欠損値の補完に SimpleImputer, カテゴリ→数値への置換に OrdinalEncoder, 標準化には StandardScaler を用いています。また、コメントの埋め込みは scikit-learn の TfidfVectorizer, LatentDirichletAllocation, TruncatedSVD を使って得ています。Bag of words を得るための分かち書きには janome を使っています。
preprocess1 でも前処理は行えますが、コードの特徴として、前処理用のオブジェクトをコードのあちこちで生成し、各カラムへ個別に fit, transform することで前処理を実現していることが挙げられます。せっかくなので scikit-learn の機能をフル活用して, fit でデータを学習し transform でカラム毎に適切な前処理を行ってくれる sklearn-like で再利用性の高い前処理パイプラインを作ってみます。つまり、
transformer.fit(data)  # データを学習する
data_preprocessed = transformer.transform(data)  # カラム毎に適切な前処理を行う
…こんなことができるようになります。次の章で具体的なやり方を説明します。
前処理パイプラインを ColumnTransformer, FeatureUnion, Pipeline で表現する
最初に挙げた前処理仕様を概念図にすると次のようになります。
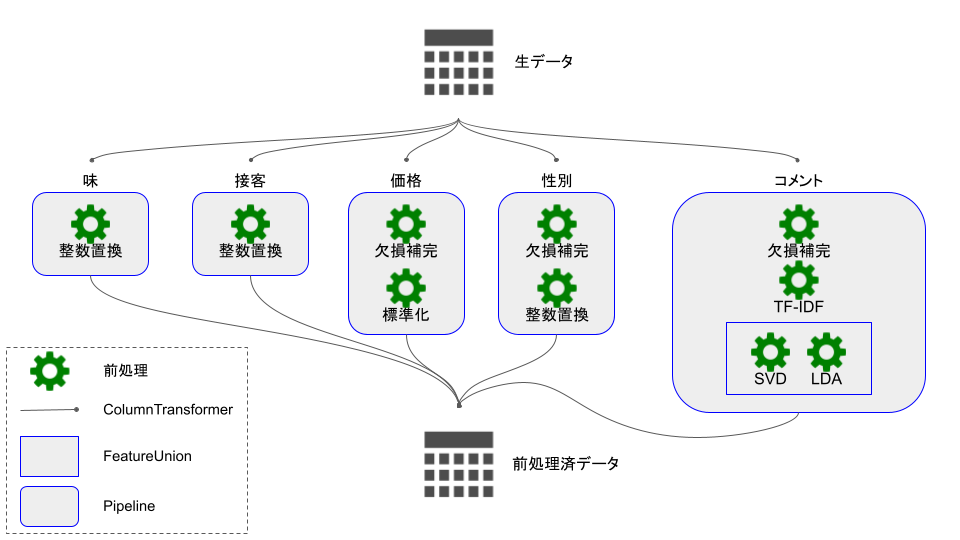
図中の歯車が「欠損値の補完」とか「標準化」等といった個々の前処理を表します. それらを組み合わせて前処理パイプラインを表現しています。
複数の前処理を直列に接続するのが Pipeline です(図中丸四角)。データに対してまず前処理①、次に前処理②…と複数の前処理を順に適用していくフローを表現できます. scikit-learn の Pipeline を使えば Pipeline を作成できます。
次に、データに対し複数の前処理を並列に実行し、それらの結果を結合する操作を表現するのが FeatureUnion です(図中角四角)。今回はコメントの前処理パイプラインの一部をこのクラスで表現しています. scikit-learn の FeatureUnion で作成できます。
最後に、データフレームのどのカラムにどの前処理を適用するかを表現するのが ColumnTransformer です(図中黒実線). scikit-learn の ColumnTransformer を使って作成します。データフレームの全てのカラムに対して同じ前処理を適用したいなら ColumnTransformer は不要ですが、今回のようにカラムによって異なる前処理を適用したい場合に非常に有用なクラスです。
これらのクラスを使った前処理用関数 preprocess2 は次の通りになります。
def preprocess2(data: pd.DataFrame) -> Tuple[np.ndarray, ColumnTransformer]:
    """データに前処理を適用する。訓練済みの前処理パイプラインも返す。"""

    # カラム毎の前処理を定義する
    taste_transformer = OrdinalEncoder(categories=[["不味い", "普通", "美味"]])
    hospitality_transformer = OrdinalEncoder(categories=[["最悪", "悪い", "良い", "最高"]])
    price_transformer = Pipeline(
        # (前処理の識別子, 前処理器) のリスト
        steps=[
            ("imputer", SimpleImputer(strategy="median")),
            ("scaler", StandardScaler())]
    )
    sex_transformer = Pipeline(
        steps=[
            ("imputer", SimpleImputer(strategy="constant", fill_value="無回答")),
            ("encoder", OrdinalEncoder(categories=[["無回答", "男", "女"]]))]
    )
    dimension_reducers = FeatureUnion(
        # (前処理の識別子, 前処理器) のリスト
        transformer_list=[
            ("svd", TruncatedSVD(n_components=2)),
            ("lda", LDA(n_components=2, random_state=1))]
    )
    comment_transformer = Pipeline(
        steps=[
            ("vectorizer", TfidfVectorizer(token_pattern=r"(?u)\b\w+\b", tokenizer=tokenize, preprocessor=lambda x: x if isinstance(x, str) else "未記入")),
            ("dimension_reducers", dimension_reducers)]
    )
    # 前処理パイプラインを構築する
    transformer = ColumnTransformer(
        # (前処理の識別子, 前処理器、適用対象のカラム) のリスト
        transformers=[
            ("taste", taste_transformer, ["味"]),
            ("hospitality", hospitality_transformer, ["接客"]),
            ("sex", sex_transformer, ["性別"]),
            ("price", price_transformer, ["価格"]),
            ("comment", comment_transformer, "コメント")]
    )
    transformer.fit(data)

    # 前処理済データと訓練済前処理パイプラインを返す
    return transformer.transform(data), transformer
このように、データに対して適用したい前処理パイプラインを単一のオブジェクト (transformer) として表現可能です。このオブジェクトは scikit-learn の API に準拠しているため fit でデータを学習し transform で前処理を実行できます。pickle で保存すれば (Python やライブラリのバージョンが合っていれば) 他環境に前処理パイプラインを移植することも可能で、システム構成の可能性が広がります。
ColumnTransformer, FeatureUnion, Pipeline に組み込む前処理は scikit-learn の API に準拠している必要があります。scikit-learn にもともと備わっている StandardScaler 等のクラスはそのまま使えるはずですが、自作の Transformer を使いたい場合は注意して下さい。scikit-learn に準拠した Transformer の作成例はこちらのブログが分かりやすいです。
終わりに
以上でデータの前処理パイプラインの作成に有用な scikit-learn の機能紹介を終わります。お役に立てば幸いです。
以上
C - XX to XXX@AtCoder Beginner Contest 259 の解法
表題のプログラミング課題に取り組んだので備忘までに解法を記録します。
課題
問題文は下記を参照。
2つの文字列 ,
に対して、「ある文字
が2個連続する範囲内に
を任意個(0個でもOK)挿入する」という操作(以下この操作を「文字挿入操作」と呼ぶことにします)を前者に繰り返し適用することで、後者の文字列に変換できるか?を答える課題です。
考え方
例えば が問題文の入力例1と同じ "abbbbaaac" の時を考えてみます。
見たまんまですが は「1つの"a", 4つの"b", 3つの"a", 1つの"c", これらを順に連結した文字列」です。つまり
の正規表現は "^ab{4}a{3}c$" です(意味が分からない方は後段の章を参照下さい)。
では が文字挿入操作の繰り返しで
に変換できるのは、
がどのような文字列(正規表現)の時でしょうか?いくつかの例を挙げて考えます。
| 正規表現 | 補足 | ||
|---|---|---|---|
| abbaac | ^ab{2}a{2}c$ | Yes | 2~3文字目の範囲に2つの "b", 4~5文字目の範囲に1つの "a" を挿入すればOK |
| abbaaac | ^ab{2}a{3}c$ | Yes | 2~3文字目の範囲に2つの "b" を挿入すればOK |
| abbaaaac | ^ab{2}a{4}c$ | No | 4~7文字目の "a" の繰り返しが多すぎて |
| aabbaaac | ^a{2}b{2}a{3}c$ | No | 1~2文字目 "a" の繰り返しが多すぎて |
| abbac | ^ab{2}ac$ | No | 4文字目の "a" を繰り返していないので文字挿入操作を行えず |
| abbaaacd | ^ab{2}a{3}cd$ | No | |
| abbaaa | ^ab{2}a{3}$ | Yes |
に対して行えるのは文字挿入操作だけであり、文字挿入操作は同じ文字が複数回連続する個所だけを対象に行えることから、
の文字が繰り返されている箇所について、
の対応する範囲では同じ文字が2~<
・・・となっていなければならなさそうです。
"abbbbaaac"
正規表現 "^ab{4}a{3}c$" に対して
が上記の条件を満たす文字列になっているかどうかは、ずばり
が正規表現 "^ab{2, 4}a{2, 3}c$" にマッチするかどうかで確かめられます。この
の正規表現は
が「1つの"a", 2~4つの"b", 2~3つの"a", 1つの"c", これらを順に連結した文字列」であることを示します。
がそのような文字列である場合のみ "b", "a" の繰り返しの箇所に適切な回数の文字挿入操作を行うことで
に変換可能です。
手順
以上の考え方を実装するには以下の手順を踏めば OK です。
とする)
} 又は {
} に置換する(置換後の正規表現を仮に
とする)
が
に置換可能と判定する(逆もしかり)
Python による解法の例
ほぼ上述のアイデアを愚直にコードにしただけです。
あたかも の正規表現を求めるには
の文字を後ろから順に見なければならないように書かれていますが、これは多分私が勘違いをしていて、前から見ても問題ないはずです。
本課題を解くのに必要な最低限の正規表現の知識
本課題を解くには「ある文字を繰り返す」ことをどのような正規表現で表すかを理解していればほぼ十分です。
"a{m, n}" は文字 "a" を 回以上
回以下繰り返した文字列の正規表現です(ただし
)。例えば正規表現 "a{2, 4}" は "a" を2~4回繰り返した文字列を表すため "aa", "aaa", "aaaa" は全てこの正規表現で表せられます。"a", "aaaaa" 等は繰り返し数が過少ないし過大なのでこの正規表現には当てはまりません。また "bbb" も繰り返す文字が違うのでやはりこの正規表現には当てはまりません。
今回の課題では に対して文字挿入操作を行う箇所を表現するために <連続する文字
>{2, <
の対応する個所での繰り返し数
>} という正規表現を駆使しました。この正規表現に当てはまれば文字挿入操作の繰り返しによって
の繰り返し数を
に増やし、当該箇所を
の対応する個所と一致させられます。
他に正規表現について理解すべきことは "^" は文字列の始まりを、"$" は文字列の終わりを表す正規表現であることくらいです。例えば正規表現 "^a{2, 4}b$" は "a" を2~4回繰り返した文字列で始まり "b" で終わる文字列を表します。"aab", "aaab", "aaaab" がこれに該当します。
その他
解法は以上の通りです。余談ですが、時間切れでコンテスト中の提出はできませんでした・・・。
B - Light It Up@エイシングプログラミングコンテスト2022(AtCoder Beginner Contest 255)の解法
はじめに
表題のプログラミング課題に取り組んだので備忘までに解法を記録する。
課題
問題文は下記を参照。
2次元座標に明かりを持った人と持っていない人が何人かずつ点在しており、後者に明かり届けるのに最低限必要な明かりの強さを求める問いである。明かりは全て同じ強さであり、明かりがあると半径 の範囲内を照らせるという舞台設定である(この
が明かりの強さ)。
考え方
以下の手順で明かりの強さを求められる。
- 明かりを持っていない人が誰の明かりにあたるべきかを特定する
- 各明かりにどれだけの強さが必要かを求める
- で求めた明かりの強さの中で最大のものが問いの答えとなる
1. 明かりを持っていない人が誰の明かりにあたるべきかを特定する
明かりの強さを最低限にするには明かりを持っていない人は一番近くの明かりにあたってもらうことになる。
例えば次の図のように人々が点在しているとする。
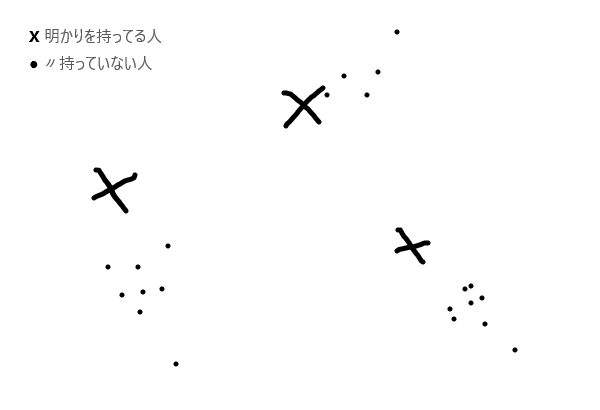
分かりやすさ重視で「左」「中央」「右」の3エリアに明かりを持つ人と持たない人が偏在するようにしている*1。この場合、各エリアの明かりを持たない人は、同じエリア内の明かりにあたってもらうことになる。別エリアの明かりにあたる輩がいると、その分明かりを強くしなければならなくなるためである。
これで明かりを持たない人がどの明かりにあたるべきかを特定できた。
2. 各明かりにどれだけの強さが必要かを求める
次に、明かりを持つ人から見て、自身の明かりにあたる人の中で一番遠くの人までの距離を求める。
先の図で考えると、各エリアの明かりから〇で囲まれた人までの距離がそれである。
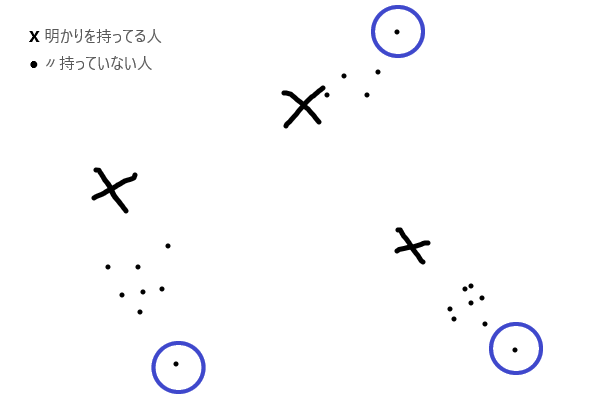
各エリアの明かりにはこの人を照らせるだけの強ささえあれば十分である。これで各エリアの明かりに必要な強さが分かった。
3. 2. で求めた明かりの強さの中で最大のものが問いの答えとなる
もはや99%答えは出ているが、2. で各明かりに必要な強さは分かったので、その中で最大のものが問いへの答えとなる。
解法
以上の手順を愚直に実装すればよい。AC(全てのテストをクリア)の Python コード例は下記の通り。 atcoder.jp
以上
*1:どのような配置でも考え方は変わらないはずである
